Un Mac può essere una piattaforma interessante per AI locale, ma il modello deve essere compatibile e stare nella memoria disponibile. La scelta non parte dal chip più costoso: parte dal lavoro che vuoi automatizzare, dalla qualità richiesta e dal software che lo esegue.
Memoria condivisa: il vantaggio e il vincolo
La memoria unificata permette a CPU e GPU di accedere al budget del sistema, ma quel budget serve anche a macOS, applicazioni e dati temporanei. Il file del modello non descrive tutto il consumo: contesto, cache e componenti aggiuntivi possono aumentarlo. Non trattare 64 GB come se fossero tutti disponibili al modello e non sommare una VRAM separata che la configurazione non possiede.
MLX, Metal e formati del modello
MLX è il framework Apple per machine learning su Apple Silicon, progettato per la memoria unificata. Un altro programma può usare un backend Metal: non sono nomi intercambiabili di un unico formato. Prima di scaricare un modello verifica architettura supportata, conversione, quantizzazione e versione del runtime. La compatibilità della famiglia non garantisce che ogni file disponibile online si avvii nella tua applicazione.
Mac e CUDA: scegli in base al progetto
Se una procedura richiede esplicitamente CUDA, un Mac non la esegue come una GPU NVIDIA. Può esistere un backend alternativo, ma va verificato sul repository e sulle dipendenze. Per coding, revisione e piccoli agenti il programma deve anche poter usare strumenti e contesto in modo affidabile. La privacy locale è un vantaggio di configurazione, non una prova che un agente non possa sbagliare o accedere a file che gli hai reso disponibili.
Air, Pro, mini e Studio
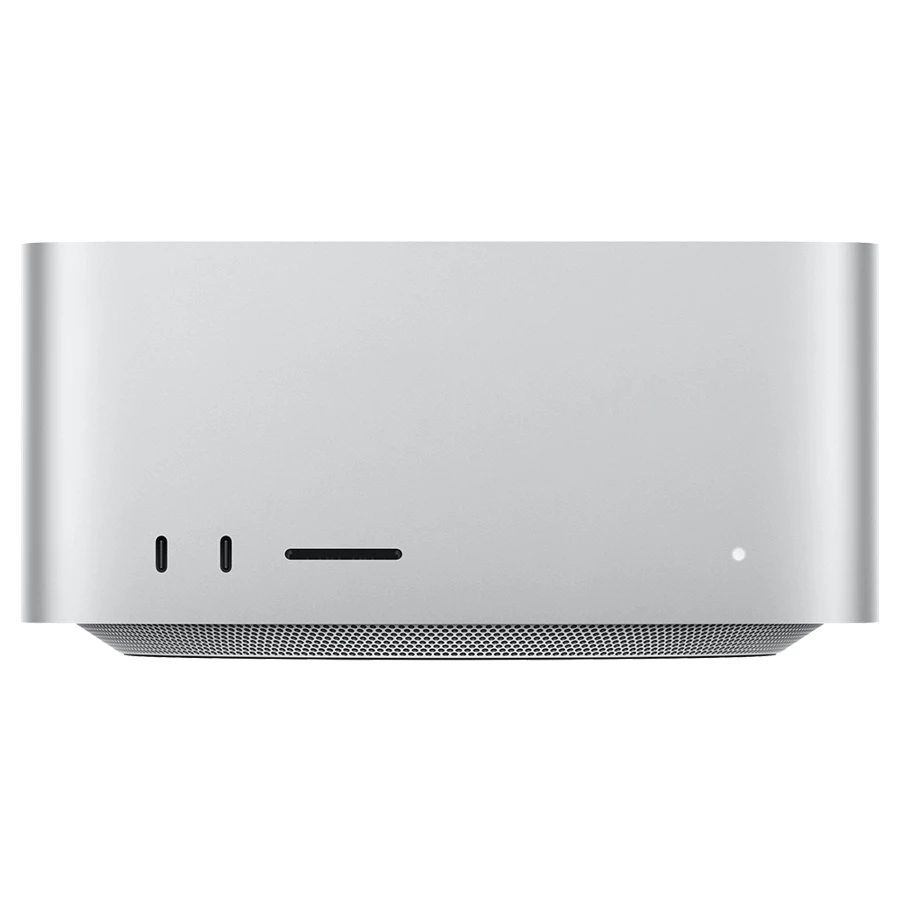
Air è da valutare per esperimenti leggeri e mobilità; Pro aggiunge raffreddamento attivo e configurazioni più ampie; mini costruisce una scrivania compatta; Studio porta fasce di memoria molto più grandi. Non scegliamo Ultra per principio: se il modello adatto al compito entra e gira in modo utile su una configurazione più piccola, il budget può essere destinato ad altro. Per sessioni lunghe valuta comportamento termico e applicazioni contemporanee.
Una prova ripetibile prima di cambiare computer
- Fissa modello, revisione, quantizzazione e runtime.
- Usa lo stesso prompt, numero di token generati e lunghezza del contesto.
- Registra tempo di caricamento, elaborazione del prompt e generazione separatamente.
- Misura memoria occupata e annota backend, versione software e altre app aperte.
- Ripeti la prova e valuta anche correttezza, coding e uso degli strumenti, non soltanto la velocità.
Perché il benchmark CPU non dà token al secondo
Il punteggio Geekbench della CPU non misura quel modello AI. Quantizzazione, banda, backend e contesto possono spostare il comportamento. Anche un confronto pubblicato dal produttore dipende dal test dichiarato: va letto con impostazioni e baseline. Nel catalogo non attribuiamo una velocità di generazione a una macchina mai provata. Per un acquisto impegnativo cerca una prova della configurazione e del modello precisi.
Prezzo e utilità
Confronta il costo del sistema completo con quello di una configurazione che possiedi già e con il servizio online che useresti davvero. Non dividere il listino del Mac per un costo per token inventato. Energia, tempo di gestione e durata utile del dispositivo sono voci distinte; entrate da noleggio o automazioni non sono garantite. Se stai iniziando, prova prima un carico piccolo e scopri quale limite incontri, poi decidi se servono più memoria o un’altra piattaforma.
Approfondisci Studio M4 Max / M3 Ultra, Studio M5 Max / Ultra e la memoria unificata.
Fonti
Consultate il 9 ottobre 2026: repository ufficiale MLX, introduzione Apple a MLX e schede Apple delle configurazioni collegate. I criteri di scelta e il protocollo di prova sono proposte editoriali.