Quando il disco entra nell’inferenza
La parte più intrigante di Colibrì è il cambio di prospettiva: un modello può essere conservato sul disco e caricato a pezzi durante l’esecuzione. Il progetto pubblico JustVugg/colibri sviluppa un motore di inferenza in C, con strumenti di supporto per preparazione, avvio e interfaccia. Colibrì esegue modelli; la qualità delle risposte dipende anche dal checkpoint scelto e dal suo formato.
Perché si parla di esperti
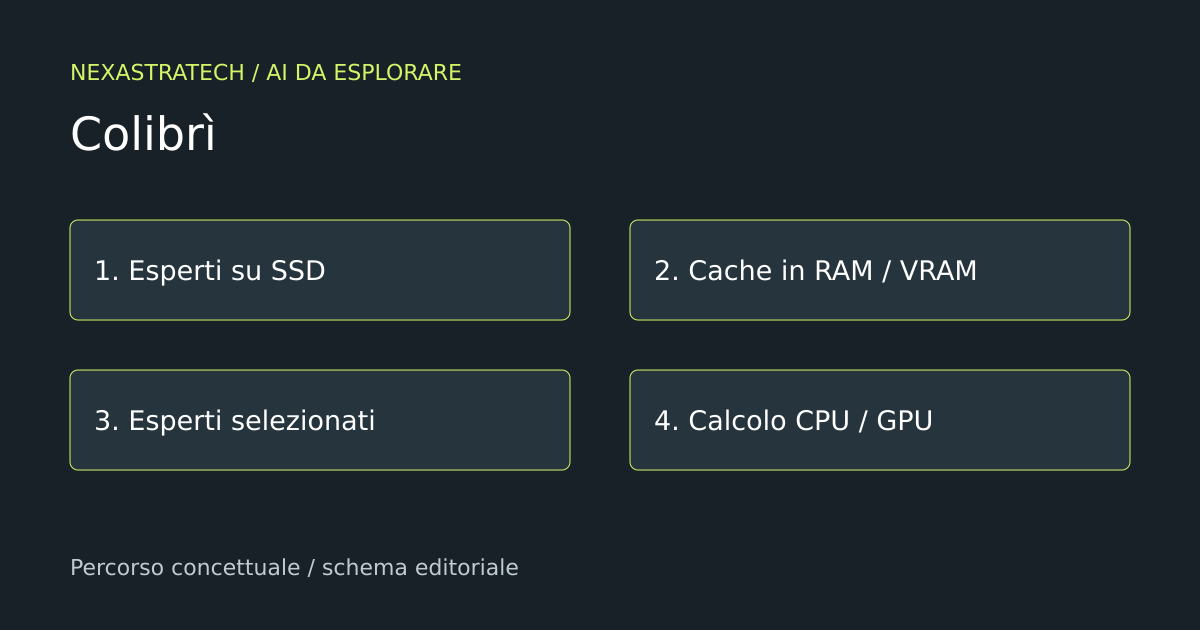
Nei modelli Mixture of Experts un router seleziona una parte degli esperti per ciascun passaggio. Colibrì organizza i pesi fra memoria della GPU, RAM e storage, caricando dal disco gli esperti necessari. Cache e prefetch cercano di ridurre le letture ripetute. Il modello completo continua a occupare spazio: una piccola quantità di RAM residente non equivale a un piccolo download.
Il caso GLM e lo spazio necessario
Il quickstart documenta GLM-5.2 da 744 miliardi di parametri e indica circa 380 GB di spazio libero per il modello int4, circa 16 GB di RAM come minimo orientativo e 24 GB o più come raccomandazione. Sono indicazioni per quel percorso, non requisiti universali del motore. La documentazione segnala anche GLM-5.3 e contenitori differenti: prima del download va controllata la pagina del formato specifico.
Cosa cambia per il proprio PC
L’SSD diventa parte del lavoro a ogni generazione. La nostra lettura pratica è che bisogna osservare quanto tempo si passa ad aspettare dati e quanto a calcolare. Un NVMe con molto spazio libero è un punto di partenza più sensato di un disco meccanico; una GPU veloce, da sola, non elimina il costo delle letture. Anche una risposta coerente può arrivare troppo lentamente per una chat comoda. Per sperimentare il comportamento del sistema questo limite può essere interessante quanto il risultato finale.
CPU e accelerazione GPU
Il percorso di base può lavorare senza GPU. La documentazione dei backend distingue CUDA, HIP/ROCm e percorsi specifici per Windows; cita inoltre validazioni circoscritte per alcune combinazioni. Occorre controllare ambiente, compilazione e modello, anziché dedurre il supporto dal solo marchio della scheda. Per verificare l’accelerazione guarda i tensori realmente residenti e gli eventuali fallback: il riconoscimento del dispositivo non dimostra che stia eseguendo il modello.
Come avvicinarsi al progetto
Il quickstart offre archivi pronti o compilazione da sorgente. Il launcher coli usa Python, mentre il nucleo di inferenza è in C. La diagnosi coli doctor aiuta a controllare l’ambiente; chat, serve e web offrono percorsi di utilizzo differenti. Il contenitore deve essere compatibile con l’engine: il normale file GGUF di un altro programma non va considerato automaticamente intercambiabile.
La prova che vorremmo vedere
Usa un prompt breve e ripetilo senza cambiare impostazioni. Registra prima token, velocità di generazione, RAM, VRAM e letture dal disco. Confronta una sessione appena avviata con una già calda, annotando modello, formato e versione del motore. Poi prova un input diverso: una cache efficace su un solo esempio può dare un’impressione troppo ottimistica. Nel selettore del sito queste architetture richiedono un percorso dedicato: la stima standard dei modelli interamente residenti non descrive lo streaming da SSD.
Perché merita attenzione
Colibrì rende l’AI locale anche un esperimento di architettura del computer: capacità, banda e riuso dei dati diventano visibili. Per chi ama capire come funziona il proprio hardware è un laboratorio stimolante. La domanda utile è quale compromesso fra spazio, memoria e attesa si ottiene con uno specifico modello.
Per continuare
Jev · CLM-8B · Selettore dei modelli AI per il PC
Fonti e approfondimenti
Documentazione consultata il 6 ottobre 2026.