
Modello e programma sono due cose diverse
Il modello contiene i parametri usati per generare le risposte. Il programma di esecuzione lo carica e gestisce richieste e memoria. Strumenti come llama.cpp e Ollama permettono di lavorare con modelli sul proprio computer; controlla formato, architettura supportata e licenza del modello scelto.
Il file non è tutta la memoria necessaria
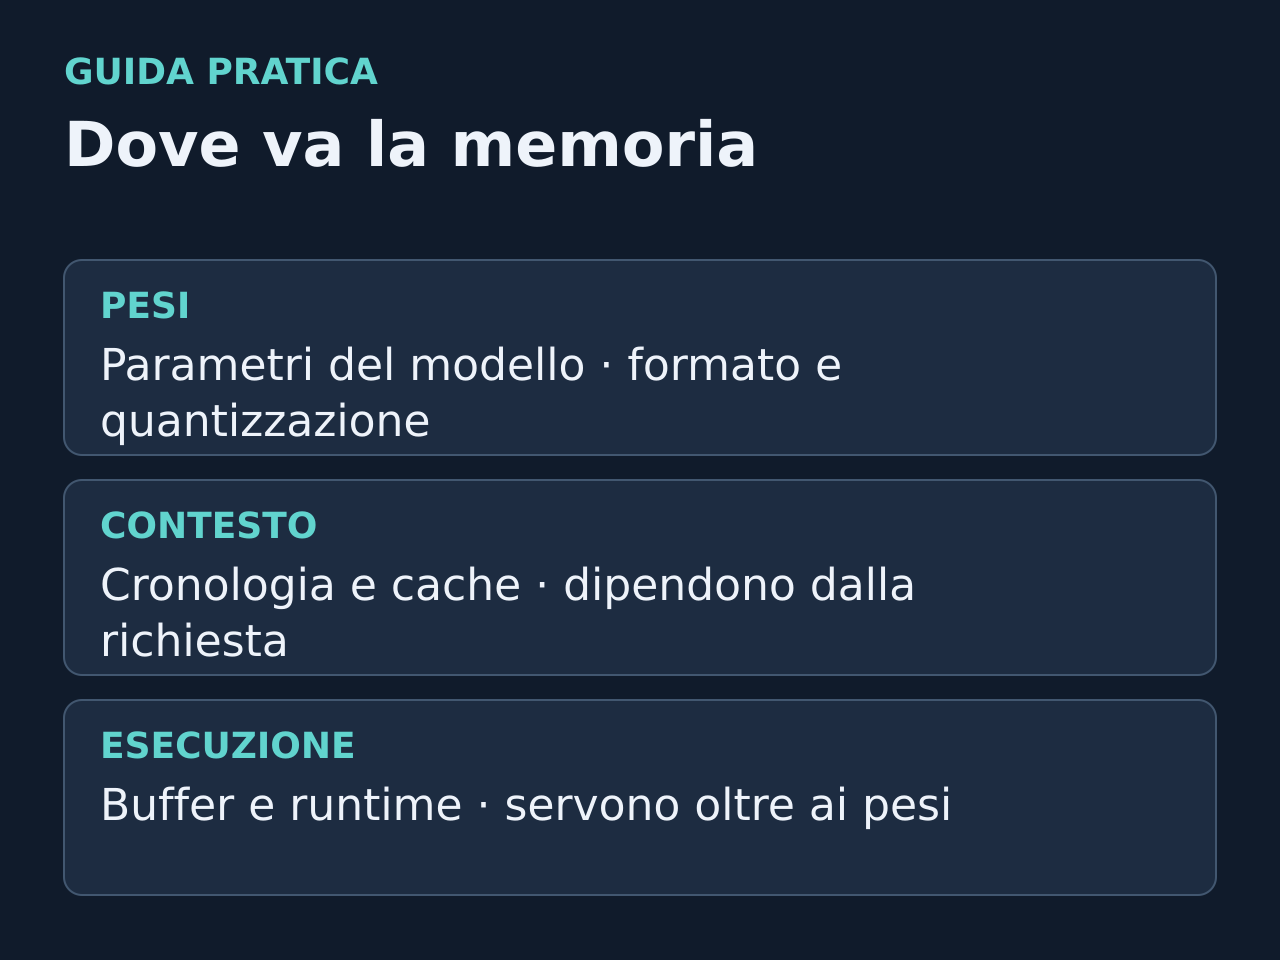
La dimensione del modello sul disco è un punto di partenza. Durante l'esecuzione servono anche memoria per il contesto, cache e altre strutture. Il fabbisogno varia con modello, programma e impostazioni. Non promettere un certo numero di token al secondo sulla base della sola GPU.
Quantizzazione e contesto
Una quantizzazione riduce la precisione con cui sono rappresentati i parametri, con compromessi da verificare sul proprio compito. Confronta varianti dello stesso modello usando richieste identiche. Parti da un contesto contenuto e aumentalo soltanto quando serve: un limite massimo supportato non è una configurazione obbligatoria.
Un primo esperimento ripetibile
- Annota CPU, RAM, GPU, VRAM e sistema operativo.
- Scegli modello, formato e variante compatibili con il programma.
- Registra versione del programma, contesto e impostazioni.
- Ripeti gli stessi prompt, distinguendo elaborazione del testo in ingresso e generazione.
- Valuta correttezza e utilità delle risposte insieme alla velocità.
Locale significa controllare anche le connessioni
Verifica se stai usando un modello locale o un servizio cloud, e quali strumenti possono accedere alla rete. Non pubblicare un endpoint di inferenza senza le protezioni necessarie. Per iniziare, preferisci una configurazione accessibile soltanto dal tuo computer.
Fonti e prossimo passo
llama.cpp e FAQ Ollama, consultati il 4 ottobre 2026. Per l'hardware consulta Schede video.
Dal file alla memoria occupata
La dimensione del GGUF è soltanto il punto di partenza: controlla le allocazioni di pesi, cache e buffer dopo l’avvio. Se il modello non entra, riduci prima il contesto e verifica il supporto del formato nel backend. Il diario delle prove mostra un caso concreto di diagnosi della memoria.
Diagnosi quando il modello entra ma la richiesta fallisce
- Conserva l’errore e le allocazioni riportate all’avvio: pesi, cache e buffer.
- Chiudi le altre applicazioni che occupano GPU e ripeti una richiesta breve.
- Riduci il contesto mantenendo lo stesso modello, per isolare il costo della cache.
- Verifica supporto del formato e del backend nella versione effettivamente installata.
- Solo dopo cambia quantizzazione o offload, annotando quale variabile hai modificato.
Un processo avviato non dimostra che tutte le richieste possibili entrino in memoria. Anche più richieste contemporanee e il percorso visivo possono cambiare le allocazioni. La documentazione di llama-server descrive le opzioni: confrontale con l’help della tua build, perché nomi e comportamento possono variare.
Controlla il caricamento effettivo
In Ollama esegui ollama ps: la colonna Processor distingue caricamento su CPU, GPU o misto. Ripeti la prova con lo stesso modello e lo stesso contesto dopo ogni modifica. Annota anche quante richieste sono attive: la memoria necessaria non si deduce dalla dimensione del download.
Verifica circoscritta del 9 ottobre 2026: offload CPU/GPU in llama.cpp, memoria del contesto e verifica delle allocazioni in Ollama. Fonti ufficiali collegate nell’articolo; nessun nuovo test di prestazioni eseguito.
